納德拉警告企業:用AI等於把商業機密拱手讓人?
「你以為自己在買智能,其實你可能在替競爭對手交學費。」這句話,如果放進微軟執行長薩蒂亞·納德拉最新這篇博文裡,可能是最貼切的注解。
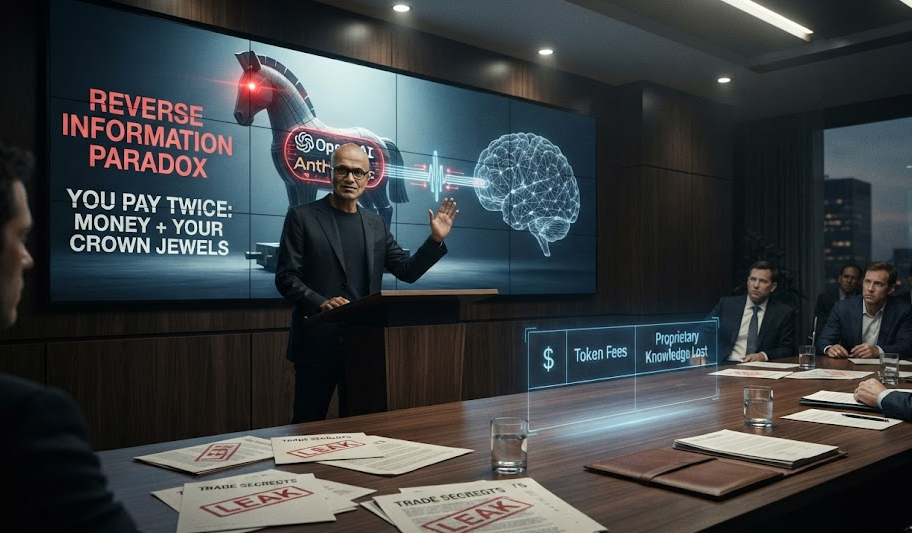
納德拉週日發表長文,向使用OpenAI、Anthropic等專有AI模型的企業發出警告:這些企業可能在不知不覺中,把自己最敏感的商業數據拱手讓給了背後的AI實驗室。他把這種現象命名為「逆向信息悖論」,並直言企業使用AI,本質上是在付雙重代價——一次是真金白銀的token費用,另一次則是更寶貴的東西:為了讓模型變得好用,企業不得不透露的專有知識。
這番言論之所以引發關注,一方面是納德拉本人的立場相當微妙——微軟持有OpenAI約27%的股份,卻公開跳出來提醒企業對這類專有模型保持警惕。另一方面,他並不是第一個發出類似警告的人,風險投資人杰森·卡拉卡尼斯、Palantir執行長亞歷克斯·卡普此前都表達過同樣的擔憂:AI實驗室可能通過客戶的使用數據,逐漸摸清客戶的業務細節,進而變成客戶自己的競爭對手。
值得注意的是,這次表態的時機也頗耐人尋味。今年2月,Anthropic就曾指責過中國的開源模型開發者,向其Claude模型發送大量提示信息以改進自身系統,並呼籲美國政府收緊出口管制。納德拉這次的言論,某種程度上被外界解讀為對這種"雙重標準"的直接回應——模型廠商既能自由抓取公開互聯網數據訓練模型,卻對別人研究或蒸餾自己模型的行為,設下重重限制。
納德拉到底在警告什麼
先看"雙重代價"這個核心表述。簡單理解,企業每一次向AI模型輸入提示、進行修正、反饋使用結果,都是在用自己的業務細節,訓練這個模型變得更聰明。納德拉特別提到"耗竭數據"這個概念——用戶編寫的提示、代理使用的工具、模型出錯後的修正,這些點滴積累起來,最終會被提煉成機構知識,而這種知識,恰恰是競爭對手花錢也買不到的。
再看"模型蒸餾"這場爭議。可以理解成,AI實驗室一邊主張自己有權利用公開數據訓練模型,另一邊卻對想要研究、蒸餾自家模型的第三方施加限制條款。納德拉認為,這種邏輯本身就存在矛盾——不能既要開放數據獲益的自由,又要對他人加以限制。
第三個值得留意的信息,是市場已經出現的實際變化。Solo.io創始人伊迪特·萊文透露,她觀察到客戶在嘗試過專有模型後,開始反問自己:能不能換成開源模型、放在本地跑,性能可以達到大模型的九成,成本卻低得多。這種轉向並非個案——據報道,上個月通過Vercel網關路由的所有流量中,有29%來自開源模型,這個比例本身就是一個值得關注的信號。
這對企業AI採購意味著什麼
看到這裡很多人會問,納德拉這番話,到底想讓企業做什麼?
對正在急於接入OpenAI、Anthropic等實驗室AI工具的企業而言,納德拉傳遞的信息很直接:你們可能正在拱手讓出競爭優勢。他建議企業保留對自身數據的所有權,包括提示和反饋內容,並在雲端搭建屬於自己的"專有學習環境"——這個建議,恰好也和微軟自家的Azure雲業務高度契合,市場猜測這也是這篇文章背後不能忽視的商業考量。
對整個AI行業格局而言,有分析認為,如果越來越多企業開始重視數據主權,轉向可以本地部署、方便切換供應商的開源方案,這可能會重塑目前由OpenAI和Anthropic主導的市場競爭態勢。納德拉還提倡構建"編排層",讓企業能在不同供應商的AI模型間自由切換,而不是被鎖死在單一供應商身上——這類AI網關工具,正在企業客戶中變得越來越受歡迎。
對雲服務商而言,這場討論某種程度上也是一次利益再分配的信號——當企業對數據主權的焦慮上升,誰能提供更靈活、更可控的AI基礎設施,誰就可能在下一輪企業技術採購中佔據更有利的位置。
真正該琢磨的,是這番話背後的角色錯位
說實話,納德拉這番"警告",聽起來像是在為企業客戶仗義執言,但細想一下,這裡面的角色關係相當微妙。
微軟自己就是OpenAI最大的投資方之一,還把GPT系列模型深度整合進Azure AI、Microsoft 365 Copilot等核心產品裡。換句話說,一邊靠著這些專有模型賺錢,一邊又提醒客戶對這類模型保持警惕——這種立場的複雜性,本身就值得玩味。
真正值得關注的,其實不是納德拉說了什麼漂亮話,而是這番言論背後透露出的行業信號:企業對AI供應商的信任,正在從"無腦all in",轉向"精打細算地保留退路"。換句話說,這場關於數據主權的討論,可能只是表象,底層邏輯其實是——企業開始重新評估,把核心業務命脈綁定在單一AI供應商身上,到底划不划算。
納德拉這篇博文,真正說明的問題是:企業使用AI的成本考量,正在從單純的token價格,擴展到更隱性的數據主權和競爭優勢層面。
這件事值得持續關注的,不是納德拉個人的立場是否自相矛盾,而是越來越多企業客戶,是否真的會因此調整自己的AI採購策略,轉向開源、本地部署或多供應商切換的方案。
未來一段時間,市場大概率會繼續觀察:主流AI實驗室是否會對這類批評作出回應,以及開源模型在企業真實業務場景中的流量佔比,是否會延續目前這種上升趨勢。
FAQ
Q1:什麼是納德拉提出的"逆向信息悖論"?
這個概念指的是,企業在使用AI模型時,理論上應該是"買方"獲取信息,但實際情況卻反過來——企業為了讓模型發揮作用,不得不透露大量業務細節和專有知識,結果變成模型提供商比企業自己更了解企業的運作方式,形成一種信息獲取上的角色倒置。
Q2:企業該如何避免在使用AI時洩露核心商業機密?
納德拉建議企業保留對自身數據、提示和反饋內容的所有權,在雲端建立獨立的專有學習環境,並構建可以靈活切換不同AI供應商的編排層,避免被單一模型廠商長期鎖定,從而在使用AI的同時,盡量降低核心知識外流的風險。
Q3:企業轉向開源AI模型,真的能達到專有模型的效果嗎?
根據業內人士的觀察,開源模型在本地部署後,大致能實現專有大模型九成左右的功能表現,但成本明顯更低,且企業對數據和運行環境擁有更強的掌控力。不過具體效果仍取決於企業自身的應用場景和技術能力,並非適用於所有情況。
相关文章